L’intelligence artificielle est partout dans le discours digital, du moteur de recommandation au chatbot qui rédige une fiche produit. Pourtant, le terme recouvre des réalités très différentes. Un outil qui classe des demandes clients, un modèle qui prévoit des ventes et un assistant qui génère une campagne de Copywriting n’ont ni le même fonctionnement, ni les mêmes risques, ni la même valeur pour ton activité.
Le piège, c’est de croire qu’une IA « pense » comme un humain parce qu’elle écrit vite, répond avec aplomb ou produit une image en quelques secondes. Dans les faits, il s’agit de systèmes conçus pour traiter des informations, détecter des régularités et produire une réponse dans un cadre donné. Comprendre cette mécanique évite deux erreurs coûteuses : rejeter un levier utile par méfiance, ou confier des décisions sensibles à un outil qu’on n’a pas évalué.
Habitué au story des 15 secondes ? Voilà ce que tu dois retenir :
| Point clé | Ce qu’il faut retenir |
|---|---|
| Définition utile | L’intelligence artificielle désigne une famille de systèmes capables d’exécuter certaines tâches cognitives : analyser, prédire, classer, traduire, générer ou assister une décision. |
| Machine Learning | Le Machine Learning est une branche de l’IA qui apprend à partir de données, au lieu de suivre uniquement des règles écrites à la main. |
| IA générative | Un LLM peut produire du texte crédible sans garantir qu’il est exact. La fluidité n’est pas une preuve de vérité. |
| Réflexe business | Commence toujours par un problème métier mesurable : temps gagné, qualité améliorée, coût réduit ou Taux de Conversion renforcé. |
En bref :
- L’IA n’est pas une machine consciente : c’est un ensemble de méthodes, de données, de modèles et de règles de contrôle.
- Les données déterminent largement la qualité du résultat, mais aussi les biais et les risques de confidentialité.
- Pour le Marketing Digital, l’IA est utile lorsqu’elle assiste une tâche précise, pas lorsqu’elle sert de gadget à publier sur LinkedIn.
- Une IA en production doit être testée, surveillée, sécurisée et pilotée par un responsable identifié.
Intelligence artificielle : une définition simple, loin des fantasmes
L’intelligence artificielle, ou IA, désigne des systèmes informatiques capables de réaliser des tâches traditionnellement associées à certaines facultés humaines. Comprendre un langage, reconnaître une image, repérer une anomalie, recommander un produit, estimer une probabilité ou générer un texte sont des exemples concrets. Cette définition est volontairement large, car il n’existe pas une seule IA, mais plusieurs approches techniques.
Le mot « intelligence » brouille souvent les pistes. Il pousse à imaginer une volonté, une conscience ou une compréhension comparable à celle d’une personne. Ce n’est pas le cas. Un modèle calcule des probabilités, applique des règles ou optimise un objectif. Il peut donner l’illusion d’une discussion naturelle, mais il ne possède ni intention personnelle, ni expérience vécue, ni sens commun fiable.
Prends Léa, qui dirige une boutique de décoration en ligne. Elle utilise un outil pour recommander des produits selon les pages consultées par ses visiteurs. Ce système peut être qualifié d’IA s’il analyse des comportements pour produire des recommandations pertinentes. Mais il n’est pas nécessairement capable de rédiger une newsletter, d’interpréter une facture ou de répondre à un client mécontent. Chaque système est conçu pour un périmètre précis.
Un système complet, pas un bouton magique
Dire « on a une IA » est un raccourci pratique, mais imprécis. Derrière l’interface propre et le champ de saisie se cache généralement une chaîne complète. Il y a des données à collecter, nettoyer et protéger. Il y a un modèle à sélectionner ou entraîner. Il y a aussi une infrastructure technique, des accès utilisateurs, des journaux d’activité, des règles métier et un système de contrôle.
Dans une entreprise, le modèle n’est donc qu’une pièce du puzzle. Un assistant interne qui répond aux questions des salariés dépend de la qualité de la base documentaire. Si les procédures sont anciennes, contradictoires ou accessibles sans filtre, l’assistant transmettra des réponses approximatives ou des informations qu’il n’aurait jamais dû exposer. Le problème ne viendra pas d’une mystérieuse révolte de la machine. Il viendra d’une architecture bâclée.
Cette distinction compte particulièrement pour la Communication et la Rédaction Web. Une IA générative peut produire un brouillon de page SEO, des variantes de titres ou une structure de campagne. Elle ne connaît pas spontanément les nuances de ton, les promesses de marque autorisées, la réalité du produit ou les objections spécifiques de tes clients. Sans cadre éditorial, elle remplit l’espace. Elle ne construit pas une stratégie.
IA, automatisation et algorithme : ne mélange pas tout
Un algorithme est une suite d’instructions permettant de résoudre un problème. Une automatisation déclenche une action selon un scénario défini : lorsqu’un prospect télécharge un guide, il reçoit un e-mail. Ce mécanisme n’est pas automatiquement une IA. Il devient plus intelligent lorsqu’il apprend à déterminer le bon moment d’envoi, le segment prioritaire ou le message susceptible de déclencher une action.
L’IA symbolique fonctionne souvent avec des règles explicites. Par exemple : « si une transaction dépasse tel montant et provient d’un pays inhabituel, déclencher un contrôle ». Cette approche reste pertinente lorsque les règles sont stables, compréhensibles et vérifiables. Elle est très utilisée dans des processus de conformité, de routage ou de validation.
L’intelligence artificielle devient plus intéressante quand la réalité contient trop de variables pour être entièrement codée à la main. Un système de détection de spam, par exemple, repère des signaux subtils dans des millions de messages. Là, une logique figée atteint vite ses limites. L’apprentissage automatique apporte une réponse plus souple, à condition de disposer de données utiles et de tests sérieux.
La bonne question n’est donc pas « est-ce de l’IA ? », mais « quelle tâche ce système exécute-t-il, avec quelles données et sous quel contrôle ? »
À lire également :

Claude passe la vitesse supérieure. Avec les modèles 4.5, Sonnet prend l’avantage sur les tâches lourdes (codage, agents, analyse), tandis que Haiku compresse la latence…
Comment fonctionne l’intelligence artificielle : données, apprentissage et réponses
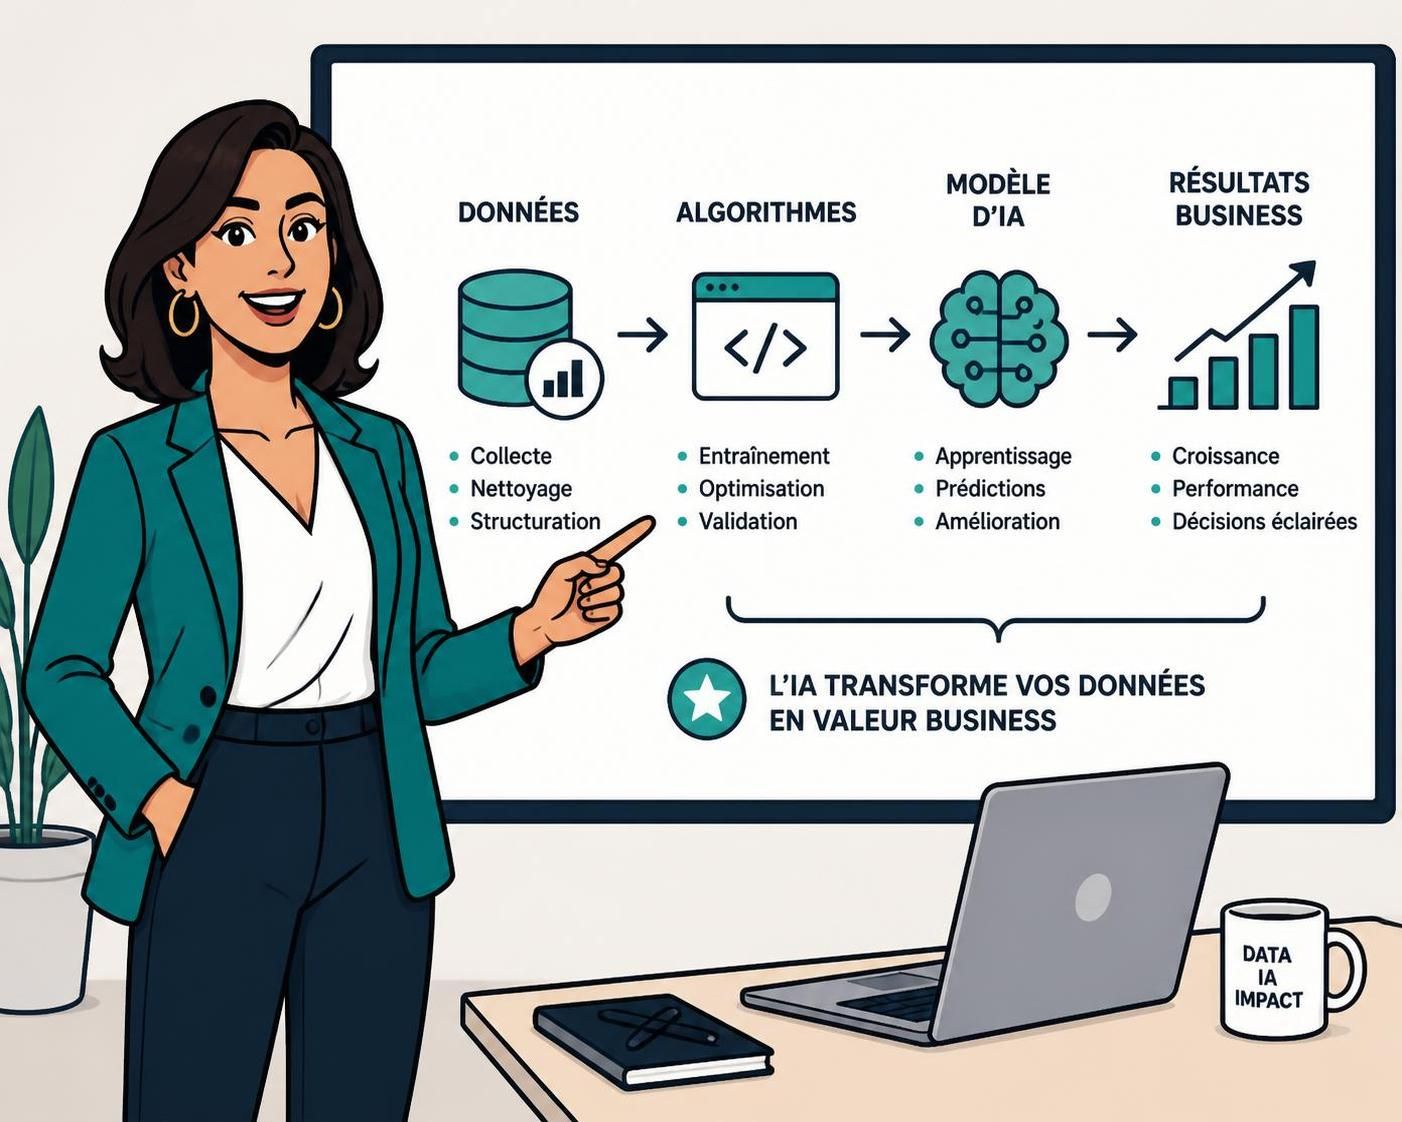
Pour comprendre comment fonctionne l’intelligence artificielle, oublie l’idée d’un cerveau numérique autonome. Pense plutôt à une chaîne de production. Les données entrent, un modèle les traite, une phase d’apprentissage ajuste ses paramètres, puis le système produit une prédiction, une classification ou un contenu. Enfin, une équipe vérifie ce qui se passe réellement une fois l’outil utilisé.
Cette chaîne paraît simple sur un schéma. En pratique, c’est là que se jouent les succès et les échecs. Beaucoup d’entreprises passent des semaines à comparer des outils alors que leur vrai problème est ailleurs : données clients dispersées, documents non à jour, objectifs flous ou absence de processus métier stable. Une IA ne répare pas ce chaos. Elle le rend plus rapide et parfois plus visible.
Les données : le carburant qui peut aussi casser le moteur
Les données servent au modèle pour repérer des régularités. Elles peuvent inclure des textes, des images, des transactions, des clics, des appels, des données de capteurs ou des historiques de vente. La quantité compte, mais la qualité compte davantage. Une base énorme, mal documentée et remplie de doublons vaut moins qu’un ensemble plus petit, propre et représentatif.
Reprenons Léa. Elle veut prédire les produits qui seront les plus demandés avant les fêtes. Si son historique ne distingue pas les ruptures de stock des baisses de demande, le modèle risque de tirer de mauvaises conclusions. Si les prix promotionnels ne sont pas renseignés, il peut confondre une hausse de volume liée à une réduction avec une tendance durable. Voilà pourquoi les projets data commencent rarement par un prompt : ils commencent par un audit.
Avant de connecter une solution à ton CRM, à tes factures ou à tes documents internes, vérifie quatre éléments :
- L’origine des données : sais-tu qui les a collectées et dans quel cadre ?
- Leur qualité : sont-elles complètes, actuelles, dédoublonnées et compréhensibles ?
- Leur sensibilité : contiennent-elles des informations personnelles, commerciales ou confidentielles ?
- Leur finalité : servent-elles vraiment à résoudre le problème défini au départ ?
Ce travail paraît moins sexy qu’un assistant qui génère des visuels. Pourtant, il protège la rentabilité du projet. Une donnée mal gérée produit une sortie fragile. Et une sortie fragile, quand elle touche à la relation client ou au pilotage financier, finit toujours par coûter plus cher qu’elle ne rapporte.
Entraînement et inférence : deux moments à ne pas confondre
L’entraînement correspond au moment où un modèle ajuste ses paramètres à partir d’exemples. En apprentissage supervisé, on lui montre des cas accompagnés de la bonne réponse : e-mails qualifiés comme spam ou non spam, clients ayant résilié ou non, photos contenant un défaut ou non. Le système apprend progressivement les signaux associés à chaque résultat.
L’inférence arrive ensuite. C’est le moment où le modèle est utilisé sur de nouvelles données. Un client envoie un message, le système identifie l’intention. Une visite arrive sur un site, l’algorithme propose un contenu. Un commercial demande une synthèse de rendez-vous, le modèle génère un compte rendu. C’est la partie visible, mais elle dépend totalement du travail invisible réalisé en amont.
Les grands modèles de langage, ou LLM, suivent aussi cette logique. Ils sont pré-entraînés sur de très vastes corpus de textes afin d’apprendre les structures du langage. Lorsqu’ils répondent à une demande, ils ne récupèrent pas mécaniquement une vérité dans une encyclopédie. Ils génèrent la suite la plus plausible selon leur entraînement, le contexte fourni et les consignes reçues.
Cette mécanique explique pourquoi un outil peut écrire un texte fluide tout en inventant une source, une date ou une référence. Il cherche une cohérence statistique, pas une vérité certifiée. Pour une tâche sensible, il faut donc ajouter des documents fiables, des règles précises et une validation humaine. Une réponse bien formulée reste une hypothèse tant qu’elle n’est pas contrôlée.
À lire également :

Les nouveaux venus à suivre : 3 réseaux sociaux qui pourraient tout changer en 2026
Les réseaux sociaux changent vite, les opportunités encore plus. En 2026, trois plateformes nouvelles ou réinventées peuvent redistribuer les cartes si tu sais où frapper…
Machine Learning, Deep Learning et IA générative : les différences qui changent tes choix
Une définition claire de l’intelligence artificielle exige de distinguer les grandes familles qui la composent. Dans le digital, les termes sont souvent utilisés comme s’ils étaient interchangeables. C’est faux. L’IA est l’ensemble le plus large. Le Machine Learning en fait partie. Le Deep Learning est lui-même une branche du Machine Learning. L’IA générative désigne des systèmes capables de créer du contenu, souvent basés sur des réseaux profonds.
Cette distinction n’est pas réservée aux ingénieurs. Elle t’aide à éviter les mauvais investissements. Si tu veux détecter des anomalies dans des paiements, un modèle de classification peut suffire. Si tu veux répondre à des questions à partir de contrats et procédures internes, un système génératif enrichi par une recherche documentaire sera plus adapté. Si tu cherches juste à envoyer un e-mail après une action, une automatisation classique fera probablement le travail pour une fraction du prix.
Le Machine Learning pour prédire, classer et prioriser
Le Machine Learning apprend à partir d’exemples. Il est particulièrement utile quand il faut prédire une valeur, attribuer une catégorie, détecter une anomalie ou trier des résultats. C’est moins spectaculaire qu’un chatbot, mais souvent plus directement rentable.
| Type d’usage | Exemple concret | Valeur métier |
|---|---|---|
| Classification | Identifier les leads susceptibles de devenir clients | Prioriser le travail commercial |
| Prévision | Estimer les ventes d’une période | Améliorer les stocks et les budgets |
| Recommandation | Proposer un produit complémentaire | Augmenter le panier moyen |
| Détection d’anomalies | Repérer une activité inhabituelle | Réduire les fraudes ou les incidents |
Dans un site e-commerce, le ranking est un cas d’usage très concret. Tous les produits ne doivent pas apparaître dans le même ordre à chaque visiteur. Le système peut prendre en compte l’historique de navigation, la disponibilité, la marge, la saisonnalité ou le contexte de recherche. Mais attention : optimiser uniquement le clic peut abîmer l’expérience. Un visiteur qui clique beaucoup puis repart frustré n’améliore ni le chiffre d’affaires ni le Branding.
Deep Learning et modèles génératifs : puissance, coût et vigilance
Le Deep Learning repose sur des réseaux de neurones comportant plusieurs couches. Ces systèmes ont changé la donne pour la reconnaissance vocale, l’analyse d’images et le traitement du langage. Leur force : apprendre des représentations complexes à partir de données brutes. Leur contrepartie : ils demandent généralement davantage de calcul, plus de données et un travail d’évaluation moins simple.
L’IA générative produit du texte, du code, des images, du son ou de la vidéo. Pour une équipe éditoriale, elle peut accélérer la recherche d’angles, le tri de verbatims, la préparation d’un plan, la reformulation ou les déclinaisons d’une Stratégie de Contenu. Elle ne remplace pas le jugement. Un contenu qui aligne les bons mots-clés SEO sans angle, sans expérience et sans preuve ressemble vite à ce qu’il est : du remplissage automatisé.
Les modèles récents deviennent aussi multimodaux. Ils peuvent traiter simultanément texte, image, audio ou documents. Cette évolution ouvre des usages utiles : analyser un tableau photographié, extraire des informations d’un PDF, synthétiser un appel client ou contrôler la cohérence d’un catalogue. Pour suivre cette évolution, l’analyse des innovations de Gemini 3 montre bien pourquoi l’intelligence visuelle et les interactions avec les outils deviennent stratégiques.
Le RAG, pour Retrieval-Augmented Generation, apporte une réponse pragmatique à la question de la fiabilité. Au lieu de demander au modèle de tout savoir, tu lui fournis les documents pertinents au moment de la requête. Il répond alors à partir de ton catalogue, de ta base de connaissances ou de tes procédures. Ce n’est pas infaillible. Mais avec des sources propres, bien découpées et citées, le système devient nettement plus contrôlable.
Choisis la technologie en fonction de la décision à améliorer, pas en fonction de la démo qui fait le plus de bruit.
Applications de l’intelligence artificielle : là où elle crée vraiment de la valeur
Le sujet n’est plus de savoir si l’IA peut générer du texte. Elle peut. Le sujet est de repérer les endroits où elle réduit une friction, accélère une analyse ou améliore une décision sans introduire plus de risques que de bénéfices. Les cas d’usage solides commencent par une tâche répétitive, documentée et mesurable. Ils ne commencent pas par « il nous faut un agent IA ».
Dans l’entreprise, les applications les plus utiles restent souvent discrètes. Recherche interne, synthèse de réunions, classement de tickets, extraction de données, assistance à la rédaction, détection de signaux faibles : ce sont des usages moins théâtraux qu’un avatar qui parle, mais ce sont eux qui trouvent une place durable dans les équipes.
Marketing, vente et contenu : accélérer sans diluer la marque
Pour le Marketing Digital, l’IA peut analyser les questions récurrentes des prospects, synthétiser des avis clients, proposer des segments d’audience et aider à tester plusieurs angles de messages. Elle peut aussi assister le Copywriting : variations d’accroches, objections à traiter, structures de pages de vente, idées de séquences e-mail ou de Publicité en Ligne.
Mais il faut poser une limite nette. La Psychologie de la Vente repose sur la compréhension d’un contexte, d’une douleur, d’une croyance et d’un niveau de maturité. Un modèle peut suggérer des formulations. Il ne connaît pas spontanément le moment où une promesse devient excessive, où une preuve manque ou où un ton commercial dégrade la confiance. C’est le rôle du marketer de trancher.
Une marque de service B2B peut, par exemple, utiliser l’IA pour lire 500 réponses à une enquête client et faire ressortir les thèmes dominants. Si « manque de visibilité sur les délais » revient souvent, l’équipe dispose d’un signal exploitable. Elle peut revoir ses e-mails de suivi, ses pages de vente et son onboarding. Là, l’outil ne remplace pas la stratégie. Il réduit le temps entre la donnée brute et la décision.
Pour aller plus loin sur des cas d’usage concrets, ce guide sur l’IA en marketing d’entreprise aide à différencier l’automatisation utile de la course au gadget. Le bon indicateur reste simple : est-ce que le dispositif améliore la qualité du message, la vitesse d’exécution ou le Taux de Conversion ? Si la réponse est floue, le projet mérite d’être recadré.
Relation client, industrie et métiers à risque
Un assistant client peut suggérer une réponse, retrouver une procédure ou résumer un historique de conversation. Il devient dangereux lorsqu’on lui donne le droit d’annuler une commande, de modifier un contrat ou de répondre seul à une réclamation complexe sans contrôle. Plus l’outil peut agir, plus les permissions doivent être limitées et vérifiables.
Cette logique vaut aussi en santé, dans la finance ou dans l’industrie. En santé, un système peut aider à repérer une anomalie sur une image ou résumer un dossier médical. Il ne doit pas devenir une excuse pour évacuer la responsabilité humaine. En finance, il peut détecter des comportements suspects, mais un mauvais modèle peut bloquer un client légitime ou laisser passer une fraude. Dans une usine, il peut anticiper une panne, à condition que les capteurs transmettent des données fiables.
L’IA peut également renforcer l’expérience client lorsqu’elle est pensée comme un outil de service. La lecture consacrée à l’humanisation de l’expérience client avec l’IA rappelle un point essentiel : un client ne veut pas parler à une machine. Il veut résoudre son problème sans perdre son temps.
Une application rentable ne cherche pas à imiter l’humain partout : elle supprime précisément les frictions qui empêchent l’humain de faire son vrai travail.
Risques, gouvernance et déploiement : utiliser l’IA sans jouer à l’apprenti sorcier
Le prototype impressionne facilement. La mise en production, elle, expose les failles. Dès qu’une IA traite des données clients, alimente une Communication externe, assiste des décisions ou se connecte à des outils métier, les questions changent : qui est responsable ? Quelles données circulent ? Que se passe-t-il si le système se trompe ? Peut-on retracer une réponse ? Peut-on stopper l’outil rapidement ?
Ce n’est pas de la bureaucratie. C’est le prix d’un usage durable. Une entreprise qui se contente d’ouvrir un accès à un assistant grand public sans cadre obtient souvent le même résultat : des gains de temps individuels, quelques documents mal vérifiés, des données sensibles collées dans des prompts, puis une direction qui découvre le sujet une fois que le risque est déjà installé.
Hallucinations, biais et confidentialité : les trois angles morts
Une hallucination est une information plausible mais fausse. Un modèle peut inventer une citation, attribuer un chiffre à la mauvaise source ou répondre avec assurance sur une règle inexistante. Dans une Rédaction Web, ce défaut produit des contenus imprécis. Dans un contexte juridique, médical ou financier, il peut devenir beaucoup plus grave.
Les biais viennent souvent des données elles-mêmes. Si un historique de recrutement contient des discriminations passées, un modèle peut apprendre à les reproduire. Si un outil de scoring a été entraîné sur des données qui ne représentent qu’une partie de la clientèle, il peut prendre de mauvaises décisions sur les autres segments. L’objectivité algorithmique est un mythe confortable. Un système reflète les choix effectués lors de sa conception, de sa collecte de données et de son déploiement.
La confidentialité demande une attention immédiate. Ne colle pas une liste de clients, un contrat non public, un mot de passe, un prévisionnel ou une donnée médicale dans un outil sans connaître les conditions de traitement. Il faut vérifier la conservation des requêtes, les accès, l’hébergement, les clauses contractuelles et les possibilités de désactivation de l’entraînement sur tes données.
Le cadre minimal pour passer du test à un outil fiable
Une gouvernance saine ne ralentit pas les équipes. Elle évite qu’elles perdent du temps sur des projets flous ou impossibles à sécuriser. Pour chaque cas d’usage, désigne un responsable métier, un responsable technique et une personne capable de valider les sujets de sécurité et de conformité. Sans propriétaire clair, personne ne corrige quand le système dérape.
Documente aussi l’essentiel : objectif, utilisateurs concernés, données manipulées, modèle choisi, limites connues, critères d’évaluation, procédure d’incident et règles de validation. Une documentation courte mais réelle vaut mieux qu’un grand discours sur l’éthique sans aucune trace opérationnelle.
Avant un déploiement, contrôle notamment la qualité des réponses, le coût par requête, le délai de traitement, la résistance aux demandes malveillantes et la capacité à expliquer les sorties. Si ton assistant s’appuie sur une base documentaire, teste volontairement des documents contradictoires, obsolètes ou incomplets. C’est dans les cas pénibles que tu verras s’il aide réellement ou s’il bluffe.
En 2025, les dépenses mondiales des entreprises en IA générative auraient atteint 37 milliards de dollars, contre 11,5 milliards l’année précédente selon Menlo Ventures. La tendance est claire : les organisations achètent davantage de solutions prêtes à intégrer et cherchent des usages réellement déployables. Cela ne signifie pas qu’il faut signer le premier abonnement venu. Cela signifie que la différence se fera sur l’intégration, les données et le contrôle.
Teste vite, oui. Mais teste sur un périmètre limité, avec des critères concrets et un bouton d’arrêt. Voilà. Tu sais quoi vérifier. Le reste, c’est toi contre ton envie de confier ton business à un outil non cadré.
L’intelligence artificielle est-elle forcément du Machine Learning ?
Non. L’IA inclut aussi les systèmes à règles, la logique, l’optimisation et la recherche. Le Machine Learning est une famille d’approches qui apprend à partir des données.
Quelle est la différence entre IA générative et IA classique ?
L’IA classique sert souvent à classer, prédire ou détecter. L’IA générative produit du texte, des images, du code ou de l’audio. Elle est souple, mais ses réponses doivent être vérifiées.
Comment réduire les hallucinations d’un modèle de langage ?
Utilise des sources documentaires fiables, limite le périmètre des réponses, ajoute des règles métier, teste des cas difficiles et conserve une validation humaine pour les sujets sensibles.
Faut-il acheter ou construire une solution IA ?
Achète lorsqu’un outil répond déjà correctement à ton besoin et s’intègre à ton environnement. Construis sur mesure si la confidentialité, la différenciation ou la complexité métier justifient l’investissement.

Moi c’est Mariane (avec un seul “n”).
J’ai troqué les process corporate contre des contenus qui claquent (et qui rankent).
Passionnée par le business en ligne, le SEO et l’IA, je transforme les idées floues en stratégies digitales qui font du bruit là où ça compte : dans les résultats. Je crois qu’avec un peu de tech, beaucoup d’audace, et une bonne dose de clarté, on peut faire exploser bien plus que des KPI.